工程师手记-将Memcached内存管理机制移植至Redis

Idea 的提出

  • Redis 有其高效的异步网络框架
  • Memcached 有其高效的内存管理机制

将这两者结合在一起后,会如何呢?开始试验将Memcached内存管理机制移植至Redis。

本篇博客的姊妹篇链接: 《工程师手记-将Redis异步网络框架移植至Memcached》

调研和选型

Redis内存管理的几个缺点:

  • 使用tcmalloc 或者 jmalloc 库,这两个库封装较重,内部特性也较多。
  • tcmalloc 适合小空间分配,稍大的空间分配会有瓶颈。
  • Redis 主要是单线程运行(只在后台任务cache持久化功能处又启动了新线程), tcmalloc 和 jmalloc 有保证线程安全,但对redis来说是不必要的功能。尤其是jmalloc,为线程安全做了很重的设计。

软件选型

  • 并不是把 Memcached 的内存管理直接替换redis的内存分配,而是使用ae-memcached的内存分配方式。
  • ae-memcached 的内存分配和 Memcached在原理上毫无不同,仅是从软件架构上对其进行重构和优化。具体参考:《AE-Memcached 优化记录》
  • 选择 Redis 2.8.24 作为移植受体

Redis代码修改和编译 / 移植方案

  • 从ae-memcached中拿出mem_cache / slab 两个类,直接移植到Redis src 目录中
  • 新建两个文件 mc_malloc.h mc_malloc.c,封装mem_cache,让其提供类似 malloc、 alloc、realloc、free的接口
  • 修改 zmalloc.c zmalloc.h 这两个文件,让其支持mc_malloc
  • 修改 Makefile ,默认MALLOC 使用 mc_malloc
  • 修改bio.c 文件,把zmalloc 和 zfree用 libc的 malloc 和 free 代替,这么做主要考虑到线程安全
  • 编译、运行

代码托管地址

给新的redis起了一个新名字mc-redis,源代码托管于Github上:

https://github.com/zuocheng-liu/mc-redis

性能测试实验

硬件

  • Redis-server 服务端 GenuineIntel 6 Common KVM processor 6 核 2.0GHZ 4G 内存
  • redis-benchmark 和服务端部署在同一台服务器上

测试方法

  • 分别运行原本Redis 和 mc-redis, 分别作为实验和对照,参数为 redis-server –port 7777
  • 启动Redis,运行redis-benchmark 测试三次。重复前面步骤,Redis共重启3次,redis-benchmark共测试9次。
  • mc-redis 的测试也使用上面方法
  • 测试命令 ./redis-benchmark -h 127.0.0.1 -p 7778 -q -d 100
  • 只观察set / get 命令的并发度

测试结果

启动一次redis,做了三组实验,数据如下:

  • mc-redis GET 62972.29 / 58275.06 / 55897.15 (requests per second)
  • redis GET 47281.32 / 62034.74 / 51759.83 (requests per second)
  • mc-redis SET 64808.82 / 59031.88 / 56915.20 (requests per second)
  • redis SET 51733.06 / 53676.86 / 56947.61 (requests per second)

结论

在刚启动时(预热阶段),mc-redis 的 set 和 get 操作,比原版redis 的并发处理能力高大约有 15%-20%。 但是稳定运行后, mc-redis 和 原版redis,性能相差较小。
AE-Memcached 优化记录

优化背景和目的

  • 学习Memcached 代码
  • 将 Memcached 的代码成为自己的技术积累
  • 优化Memcache 代码,提高自己系统分析能力

源代码托管于Github上:

https://github.com/zuocheng-liu/ae-memcached

性能优化

网络模型的优化

  • 网络IO多路复用 + 单线程

  • 将 Redis 异步库 移植至 Memcached

优化动态申请内存机制

  • 使用预分配,减小系统调用 malloc、realloc、free的次数,主要出现在新建/关闭链接时,会有较多的系统调用

部分小的函数使用宏代替

优化Memcache协议命令的解析

  • 调整各个命令的解析顺序,把get 和 set 命令放到最前面

软件架构优化

软件架构优化,保证关键代码性能不变

使用宏加强代码复用

  • 重构verbose日志
  • 重构网络库
  • 重构slab

命令模式重构 Memcache 协议

  • 创建command_service类,统一管理命令的解析、处理

更深层次的抽象

将 stats 、 settings 、 logger 和全局资源进行抽象

解耦

  • 将各个模块接口化,减少模块间耦合,尤其是 slab item memcached之间的耦合
  • 依赖注入原则,增强各个模块的复用,其中mem_cache模块 settings等可以形成框架。
  • logger
  • command service

工程师手记-将Redis异步网络框架移植至Memcached

Idea 的提出

  • Redis 有其高效的异步网络框架
  • Memcached 有其高效的内存管理机制

将这两者结合在一起后,会如何呢?

本篇博客的姊妹篇链接: 《工程师手记-将Memcached内存管理机制移植至Redis》

调研和选型

Memcached 的几个缺点:

  • 使用封装较多的 libevent 异步库
  • Memcached 1.2.2 版本后,开始使用多线程,而多线程上下文切换、互斥锁的竞争带来了一定的性能开销
  • 每次新建tcp 连接都进行系统调用(malloc)申请空间

对Memcached 的一项性能测试

实验验证,多线程不会对Memcached带来性能的提高

参考链接:

对Memcached 1.2.2 的一次基准测试实验

软件选型

  • 从 Redis 3.2.0 (截止此文最新稳定版) 版本中选择 libae、 libanet (ae.h、ae.c、anet.h、anet.c 四个文件)
  • 选择 Memcached 1.2.0 作为移植受体

选取这两个版本的主要原因是,作为Redis 和 memcached 的早期版本,特性较少,代码复杂度低,适合进行初步实验移植。

为什么不直接使用epoll呢? 因为除了异步框架之外,还需要定时器的功能,而redis的异步库中已经有现成的实现。

代码托管地址

给新的memcached起了一个新名字ae-memcached,源代码托管于Github上:

https://github.com/zuocheng-liu/ae-memcached

性能测试实验

硬件

  • Memcached 服务端 GenuineIntel 6 Common KVM processor 6 核 2.0GHZ 4G 内存
  • Memcache 客户端 和服务端相同的另外一台服务器

测试方法

  • 分别运行Memcached 和 ae-memcached, 参数为 memcached -m 1024M -t 6 , 其中原本memcached运行6个线程,而ae-memcached 是单线程
  • 使用memslap 1.0.2, 测试10W次请求,100的并发度的情况下,memcached的处理时间
  • 测试命令 ./memslap –servers=test-server:11211 –concurrency=100 –execute-number=1000 –tcp-nodelay –non-blocking

测试结果

  • ae-memcached 6.709 / 6.878 / 7.362 / 7.196 (seconds) 平均7秒
  • 原版 memcached 5.079 / 5.043 / 5.069 / 5.206 (seconds) 平均5秒多

结论

原版Memcache 处理10W条数据的时间要比 ae-memcached少很多。多线程的确会给Memcached带来性能的提升.我们前面的假想并不正确。

对 Memcached 的持续优化

本文作者不仅只把Redis的异步库移植至Memcached,还对Memcached进行了持续的优化,详细请阅下面链接:

http://it.zuocheng.net/ae-memcached-optimization-zh

对Memcached 1.2.2 的一次基准测试实验

猜想假设

memcached这种系统的瓶颈在网络,不在计算和存储,而使用多线程,只能优化计算。用了多线程,反而会有上下文切换的代价。

测试概要

测试目标

让 Memcached 分别采用 单线程模型 和 多线程模型, 并对其性能进行对比

测试方法

测试软件

实验组 Memcached 1.2.2 (IO 多路复用 + 单线程)

对照组 Memcached 1.2.2 (IO 多路复用 + 多线程)

Memcached 1.2.2 是 Memcached 众多版本中的一个临界版本,在Memcached 1.2.2 之前的版本采用 “IO 多路复用 + 单线程” 模型, 在Memcached 1.2.2 之后的版本则采用 “IO 多路复用 + 多线程” 模型。

测试工具

memslap 1.0

测试环境

  • 软件 Ubuntu 15.10
  • 硬件 Intel(R) Core(TM) i5-3470 CPU @ 3.20GHz 4核 2G 内存

测试步骤

搭建

  • 编译 memcached

先编译单线程的 memcached 版本。(正常编译,作为实验组)

再编译支持多线程 memcached 的版本(作为对照组), 编译方法如下:

修改configure.ac文件,将下面一行

AC_DEFINE([USE_THREADS],,[Define this if you want to use pthreads])

改为

AC_DEFINE([USE_THREADS],1,[Define this if you want to use pthreads])

执行 sh autogen.sh , 然后执行 ./configure --enable-threads ,最后执行 make

  • 分别运行 实现组和对照组的memcached, 然后对其进行基准测试

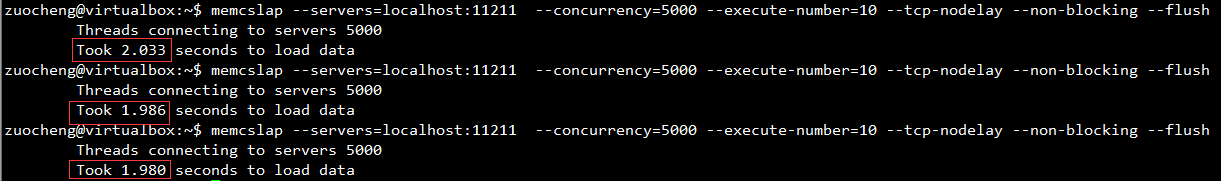
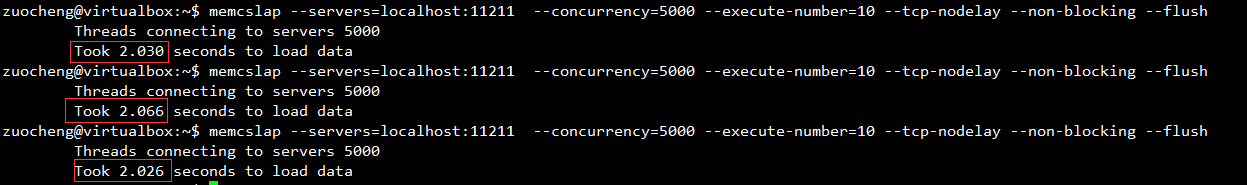
命令示例: memcslap --servers=localhost:11211 --concurrency=5000 --execute-number=10 --tcp-nodelay --non-blocking --flush

–concurrency=5000 –execute-number=10 这两个数据多次选型,反复测试。

实验结果

选取典型实验结果数据

  • 实验组 (单线程)

实验组 (单线程)

  • 对照组 (多线程)

enter image description here

实验推导结论

从上面的实验结果看,单线程的性能要比多线程性能略高。