多线程编程的陷阱

依据《Java 并 发编程实践》/《Java Concurrency in Practice》一书,一个线程安全的 class 应当满足三个条件:

  • 从多个线程访问时,其表现出正确的行为
  • 无论操作系统如何调度这些线程,无论这些线程的执行顺序 如何交织
  • 调用端代码无需额外的同步或其他协调动作

不安全的多线程编程容易造成哪些后果

  • 内存泄露
  • 资源、数据访问冲突、数据不一致
  • 进程空间用尽
  • 计算资源耗尽

* 错误处理不当导致整个进程异常结束

数据访问

  • 冲突
  • 不一致

多线程间共享的标志变量, 可能被编译器优化,存储于cpu寄存器,一个线程将其值改变(内存值),在另一个线程的cpu寄存器对应的值却未同步。

解决方法: 1. 添加 volatile 关键字修饰变量。 并且加互斥锁。 2.不使用共享的标志变量。

内存空间使用的安全性

  • 防止内存泄露,小心使用堆空间

  • 小心使用栈空间

逻辑的安全性

  • 参数检查一定要严格,任何一个不合法的参数能让线程异常,然后整个app异常

  • 容错

内存泄露原因

软件的稳定性

  • 如果一个线程体挂掉

?

  • 悬空指针

释放时设置为NULL 声明定义时设置为NULL

线程空间限制

  • 所有线程受限于进程的空间
  • 系统会限制线程的栈空间(默认是10M)

在大规模软件设计中,线程数量的设定和栈空间的使用必须要小心。

高效使用栈空间技巧

  • 如果使用大的内存空间,则到堆里去申请
  • 不使用递归算法,而使用循环,也要避免使用递归算法的库
  • 更加细致地拆分逻辑或模块,让函数体量更小
  • 复杂数据类型(类或者结构体)做为函数参数时,尽可能传递它们的指针或引用,以节省栈空间

多线程下的设计模式

资源竞争与互斥

  • 单例模式

循环中不使用wait

多线程下的全局变量、资源

线程安全

语言特性 valatile

内存泄露

和多进程编程相同的陷阱

运维的安全性

如果程序在线程在启动时固定,则在可动态扩展的容器中,可能会有因为线程数过多而不能充分使用cpu资源。在性能压力测试时,常常会引起在cpu资源使用率较低时,系统则已经到达瓶颈。

Nginx 和 PHP 的两种部署方式比较

2种部署方式简介

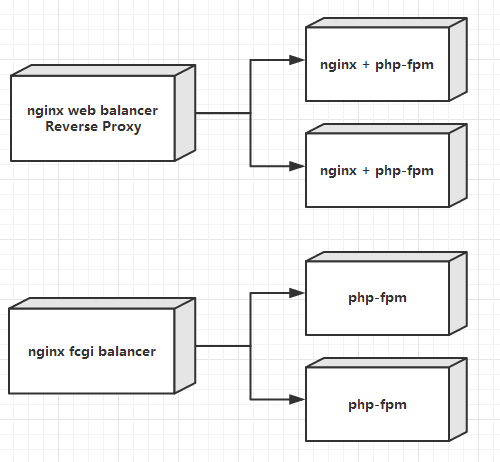
第一种

  • 前置1台nginx服务器做HTTP反向代理和负载均衡
  • 后面多态服务器部署Nginx Web服务和php-fpm提供的fast cgi服务

第二种

  • 前置1台nginx服务器做Web服务
  • 后面服务器只部署php-fpm服务,供nginx服务器调用
  • 前置1台nginx服务器,在调用后面多例php-fpm服务时,也可以做到负载均衡

如下图 :

 2种部署方式

对比

从系统设计角度

第一种部署是常见部署方式,大中小规模网站都能适用。

第二种,web服务和php-fpm服务部署在不同服务器上,更加细致。但有几个问题:

  • 前置nginx充当Web服务。对静态资源的访问、压缩传输、缓存设置等,也都集中在这台服务器上。一旦访问量变多,压力变大,容易成为瓶颈。
  • 如果静态资源都存放于CDN,不需要HTTP 压缩传输,这种部署方式还算比较合理;
  • 承接上面两点,还可以对这种部署方式进行优化。如前置nginx负载均衡和反向代理,中间是nginx Web服务,后面部署php-fpm服务。

从性能角度

相比第二种部署方式,第一种多走了一次进程间交互。

  • 按照第一种部署,当一个http请求过来,先是nginx反向代理转发至nginx Web服务(通过网络),Web服务再通过fastcgi协议与php-fpm进行交互(进程间交互);
  • 按照第二种部署,当一个http请求过来,充当Web服务的nginx,直接通过网络与php-fpm进行交互

第一种部署,通过网络交互的是HTTP协议,第二种通过网络交互的是fast-cgi协议, 这两种协议对比如何呢?

  • fast cgi 的数据包会比HTTP稍微大一些,fast cgi协议会比HTTP携带更多的参数信息、传输控制信息等等。
  • fast cgi 协议比HTTP协议格式化严格一些,解析起来速度更快一些。

从运维角度

  • 第一种是最常见的部署方式,后面所有服务器上的服务都是同构的,简单粗放。

  • 第二种则是将nginx和php-fpm单独分开部署,不同服务在服务器集群上的分布更加细致。通过统计Web服务中的压力分布,可以更加精细地利用硬件资源。运维成本也更高。

从开发测试角度

两种部署方式都不合适开发环境或测试环境,都仅适用于生产环境。

开发和测试环境把nginx和PHP部署到一台服务器上即可,也不需要反向代理和负载均衡。

总结

如果是LAMP环境的部署,第一种比较常见。

如果不是LAMP,是nginx和其他fastcgi服务交互,比如C/C++、java的fastcgi程序,在大规模的网络应用中,类似第二种的部署是常见的。做到不同服务之间分开部署,反而是简化了系统的网络结构,更加便于维护。

后记

此篇博文的内容,都来自于和百度前同事在QQ群里的讨论。

本博客搭建和定制方法

搭建环境

硬件

  • 阿里云服务器

软件

  • LNMP 环境(Linux + PHP + Nginx + Mysql)
  • WordPress

定制本博客的Wordpress 功能

博客主题

Twenty Eleven, 简约风格

博客文本编辑器

使用了WP-Markdown 插件,可惜不支持GitHub 扩展的特性

HTML h3 标题又小又不明显 怎么办?

在主题目录 wp-content/themes/twentyeleven/style.css 中,h3 元素样式添加 font-weight: bold;更改front-size为12px。

h3 {
    font-weight: bold;
    front-size: 12px;
}

添加缓存,提高博客响应速度

WP Super Cache 插件

让列表页只显示文章标题,而不把文章标题页显示出来

修改主题中文件,在 content.php 中,把调用the_content函数的语句注释掉

在文章末尾添加文章签名,如果文章被别的网站扒去,也可以把来源显示出来。

修改主题中文件,content-single.php,

在content-entry 里添加如下代码

转载请注明来源,原地址保持永久更新。
博客首页:作程的技术博客
文章标题:>《》
本文链接:>

访问 http://it.zuocheng.net/sitemap.xml 提示错误

把xml 注释去掉,修改aioseop_sitemap.php

//$this->comment_string = __( Sitemap %s generated by All in One SEO Pack %s by Michael Torbert of Semper Fi Web Design on %s, 'all_in_one_seo_pack' );

添加链接 (书签、友情链接等)

在数据库中,把wp_options.link_manager_enabled项设置为1

支持HTTPS

使用了 let’s encrypt 的证书

所使用的插件列表

  • All In One SEO Pack //用于SEO
  • Disable Google Fonts //禁止调用google字体,国内请求慢,不然会降低网站响应速度
  • Google XML Sitemaps //生成xml,SEO
  • Query Monitor //监控,一般情况下禁用
  • Table of Contents Plus //显示文章结构
  • Wordfence Security
  • WP Clean Up
  • WP Super Cache
  • WP-Markdown
  • WP-PostViews
  • WPtouch Mobile Plugin //让博客对移动端友好
  • 多说 //社会化登陆
  • 百度sitemap //百度搜索SEO
  • WP-Statistics //统计,包括来访、IP、展示数等等

更新、安装 直接下载,不使用FTP

修改wp-config.php,添加命令:

define("FS_METHOD","direct"); 
define("FS_CHMOD_DIR", 0777); 
define("FS_CHMOD_FILE", 0777); 

系统优化

使用 Unix domain socket,减小 LAMP 通信代价

Nginx 和 PHP ,PHP 和 Mysql 通信都使用Unix domain socket,并且把套接字文件放到内存文件系统/dev/shm下面

mysqld 有大量sleep进程,占用过多内存。

添加mysqld配置

[mysqld] wait_timeout=120 interactive_timeout=120

统计过滤机器人列表

服务器迁移

数据迁移

把数据表导出
[admin@src]mysqldump -uroot -password BLOG > /tmp/DB.sql
scp 到目标机 scp /tmp/DB.sql target:/tmp
在目标机导入数据库
mysql>use DB; souce /tmp/DB.sql;
配置权限
grant all privileges on DB to user@'%' identified by 'password';
grant all privileges on DB.* to user@'%' identified by 'password';
flush privileges;

msyql 8之后版本
CREATE USER 'user_name'@'%' IDENTIFIED BY 'pass';
grant all privileges on *.* to 'user_name'@'%';
flush privileges;
工程师手记-PNI

PNI 简介

PNI,是PHP Native Interface的简写。它是PHP的一个扩展,可以通过它,让PHP直接调用C语言写的函数。

想法源自在百度做项目时,不时地会面临同样一个问题,PHP该如何直接快速地与其他语言交互呢?

PHP 扩展的不足

用C写PHP的扩展是常规的方法。不过使用这种方法总是要面临诸多问题:

  • 作为开发者,要去学习PHP-API、Zend-API,这是不小的学习成本,而且用C做开发测试的效率都不高。
  • 写好了PHP扩展,怎么部署呢,还要找运维工程师去讨论、去争取后才能上线。

来来回回项目进度就被拖慢了。

有如此技术痛点,就找个通用的法子吧。

调研过程

JNI 和 Python

Java 可以通过JNI调用C/C++,Python也有相应的包,比如ctypes

HHVM

稍微去翻了一下HHVM的扩展,发现HHVM有 native interface, 但稍微看了一下,却发现那只是HHVM的native interface,PHP无法使用。

这个项目,模仿JNI,就取名PNI吧

c 对动态链接库的动态调用

c 加载动态链接库及调用函数有现成的方法。

使用dlfcn.h 库中的dlopen、dlsym、dlclose三个函数就够了。

设计和实现过程

接口设计

最开始的方案,就是模仿JNI。因此在最初的实现里,PNI对动态链接库的查询,调用函数的方法都直接模仿了JNI的接口实现。测试使用时,却感觉PNI的接口非常不友好。

和Java、Python 不同,PHP是弱类型语言。JNI 可以在给函数传递参数时,参数的数据类型是已知的,但是PHP传的都是zval,类型并不可知。我把数据类型的控制交给了开发者,在PNI的扩展里,通过struct zval 中 type 字段判断,此种方案让PNI很难于被使用。

于是改进方案,在PNI里添加PNIInteger、PNIDouble、PNIChar和其他几个可以标明参数数据类型的类。

参数压栈

PHP 的函数调用后,动过dlfcn.h库,可以找到函数地址,但是如何调用函数呢?调用函数又如何传参呢?我们无法知道所调用函数的参数列表是什么样子。

由于没有找到比较好的方案,所以就借助于汇编,使用汇编模式C语言的参数压栈方法。

于是写了很多种C语言的函数,主要是参数列表不一样,总结了GCC编译器在x86_64架构CPU下参数压栈的几个特点:

  • 8、16、32位和64位整形的参数,按顺序传到64位的寄存器,当多于6个整形参数时,剩下的整形参数都压栈

  • 32位和64位浮点,都传到64位的浮点计算器,浮点参数多于6个时,剩下的浮点参数都无效

无论C函数的参数是什么样的类型,PNI都将其按64位的整形或浮点处理。

问题解决了

系统兼容性

因为参数压栈的问题,目前PNI只支持GCC编译器和x86_64架构的CPU。其他架构和编译器都没有来得及去实现。

总结

吭哧吭哧,PNI最初版本调试测试成功。

后记

如何让PNI被更多的人知道并使用,怎么做呢?(还在思考中)

  • 开源,传到GitHub
  • 融入社区
  • 在问答网站上多回答相关问题

其他方法呢?再想一下。

工程师手记-赶集易洗车后台和服务端

项目简介

赶集上门洗车业务服务器端,分为两部分:

  • 为洗车APP提供服务的接口
  • 洗车业务相关的管理后台

从整个项目上说,虽是个创业项目,但需求针对性强,从洗车仅一点上切入,易于发力。

相比曾经经历一些创业项目中,产品总是摸不住方向,不知何处发力,试错成本太高,做到最后都迷茫该做什么,怎么做。还有些项目,铺开面去搞,结果摊子太大,顾及不暇。

赶集易洗车与之相比要好太多,对我来说,做这个项目感觉很舒服。负责时间:2014-11 至 2015-08

框架代码

主要开发语言是PHP。典型 LNMP 架构。

代码框架是赶集网多年积累下来的老框架,对于老框架,工程师都是能够理解的,不过还是想说一说。

  • 简易实现的路由分发
  • 没有清晰的分层概念
  • 有一套简单的DB访问工具类
  • 对其他架构系统调用封装访问很全面
  • 赶集所有频道都使用一套框架代码

总之,有优有劣。

业务代码

虽然使用了类,但仍然使用了面向过程的思维在开发。代码复用性、可扩展性比较低。由于业务简单代码耦合还不是很严重。

代码没有分层也是问题。

项目发展过程

框架的改进

赶集易洗车框架和其他MVC框架的诟病一样,表现层逻辑直接调用数据访问逻辑,并没有业务逻辑层。于是劈出一个目录,存放业务逻辑层代码。建立规范约束DB层和表现层,老的业务逻辑代码日后慢慢迁出和重构。

面向对象

老逻辑中类的作用只被用于聚合。多态和继承并没有被使用。

对DB层的再次封装

在DB访问类,由于历史原因,用起来特别不友好,也有让新人不易察觉的逻辑陷阱。

对此,我使用了Service Locator Pattern + Proxy Pattern 这两个设计模式,对原DB层再次进行封装,简化上层对DB层的调用,添加缓存的优化。之所以使用这个方案,主要是根据项目当前情况,有如下考虑:

  • 不能抛弃和重构原有的DB访问类, 因此选择再其之上再进行封装。遵循开闭原则,不对老逻辑进行改动
  • 原有DB访问类有逻辑陷阱,因此使用Proxy Pattern,把陷阱的规避放到proxy类中,优化对外的接口
  • 原有DB类,每一个数据表都对应一个DB类,全局只需初始化一次,但会在不同的地方多次调用,所以选用Service Locator Pattern,每个DB类,初始化1次便缓存起来,供之后逻辑重复使用

用了上面的方案后,代码可维护性和可读性都提高了。

展示列表的封装

后台有很多的展示列表页面,主键往往是一样的,比如都是订单的ID,但是其他的列,有的一样,有的不一样。可以看成,不同的列表页面,就是不同的列的组合。

使用Decorator Pattern 对其进行重构。这个设计模式比较简单,但是实在是特别好。在我之后的开发工作中,凡是遇到列表,开发的时间估计就能缩小一半。维护的成本则是更低。

具体业务开发

具体业务的开发,也许是最枯燥的工作,不具有挑战性,只能付出劳力。估计只有在机器人程序猿出现后才会解决这个问题。

关于团队

团队每周有分享,可怜创业项目排期紧张,团队分享没有坚持几期,后来慢慢停掉。原因我认为可以从两个方面看:

  • 随着业务压力的增大,团队给予技术成长上的提升关注也会消弱。
  • 人有惰性,团队往往也是如此。

我在团队分享3次,《地理区域和点关系计算》、《代理和反向代理》、《PNI》 , 分享积分是团队最高的,本来有一部kiddle做奖品,团队解散后也没去要过来,哈哈。

开始写工程师手记

从12年4月大学毕业开始实习,至今工作3年半经验。

回忆这三年半,这些经验都给我带来了什么呢?不容置疑,有很多东西,但是具体有哪些呢?不好好收拾一下脑海,真就不能立刻说出来。

所以昨晚上班路上就想出了写工程手记这么一个idae,有了手记,我就不会对做过的项目有种“彻底忘记”的感觉了。自己做过什么,一看手记立刻就能回忆起来,曾经的经验、走过的陷阱、当时的思考,都可以立刻回到自己的身上。

通过工程手记,还可以记录在做项目过程中的所感和所想,以后也可以拿来回顾和反思,说不定能得到更多的东西。

总之,就是让自己以往的经历,不仅仅只是流逝的时间,只是过往的履历,一定要变成有价值的经验。

手记的内容

  • 项目简介 (what 、 when 、who)
  • 所遇问题 (why)
  • 如何做的呢? (how)
  • 总结和反思

给自己的手记制定几点原则

  • 原公司保密的东西不以泄露
  • 从客观角度描述问题,尽可能不夹带个人感情倾向
  • 不随意否定项目、团队或个人
  • 内容保持精简,不谈无关话题

写手记的想法是怎么来的呢?

主要是源于两件事吧。

刚玩微博时,关注了易胜华律师,从他发的内容里知道他有写律师手记的习惯。他的手记里,都记录着每次办案的一些重要或关键的细节,也包括他思考的过程。看了后深感佩服,不愧是名律师啊。

在大学时,曾是学校越野队队员,队里规定每次比赛完必须要写比赛总结。总结的目的很明确,就是经过每次的比赛,都能让队员有所提高。

所以我们软件研发工程师为什么不能有手记呢?

二进制运算技巧

假设都在x86或x86_64架构CPU上进行运算,二进制基本运算包括,加减乘除、与、或、异或、同或、移位

假设n 为 32 位整形数,取正整数n除以8的余数 : n & 0x07

假设n 为 32 位整形数,取正整数n除以16的余数 : n & 0x0F

假设n 为 32 位整形数,8位对齐 : (n + 7) & 0xFFFFFFF8)

假设n 为 32 位整形数,32位对齐 : (n + 31) & 0xFFFFFF80)

假设n 为 32 位整形数,求8位对齐填充位数 ((n + 7) & 0xFFFFFFF8) – n;

求int 最大值 : (1 << 31) – 1 或者干脆 0x7FFFFFFF

求int 最小值 : 1 << 31

判断奇偶数 : n & 1 == 1

交换a b 两个变量的值 : a ^= b ^= a ^= b;

n 乘以2的m次方 : n << m

spawn-fcgi 源码分析

梗概

本文内容对Spawn-fcgi源码进行解读,简要说明其原理,并具体说明其实现方式。

Spawn-fcgi 源码虽然只有600多行,但是初次阅读起来依然需要花很多时间。为了节省读者的学习成本,提高学习Spawn-fcgi 的效果,作者对Spawn-fcgi的源码做了裁剪,保留最核心的功能和原有的代码结构,且能编译后正常运行。最后代码只有200多行。

源码地址在这里

必备知识

要阅读Spawn-fcgi,读者至少需要掌握以下几个方面的知识或技能:

  • 了解CGI和FastCgi的概念,了解其使用场景
  • 基础的Linux C 环境编程,会使用常见的库函数比如getopt、exec 等
  • 基础的Linux C 的多进程编程,熟悉fork、waitpid、setsid等函数
  • 基础的Linux C 网络编程,熟悉建立tcp连接、select非阻塞方式通信,多路复用I/O等

裁剪后Spawn-fcgi的执行过程

  • 创建服务器socket
  • fork进程,子进程初始化会有两个主要操作:
  1. 把socket的文件描述符,复制到FCGI_LISTENSOCK_FILENO
  2. 会执行execl 函数,运行cgi程序,并让cgi程序拥有子进程的上下文环境

    运行cgi程序后,使用FCGI_LISTENSOCK_FILENO这个描述符,来与webserver进行通信。

如何编译

gcc -o spawn-fcgi spawn-fcgi.c

一行命令即可

如何调用

./spawn-fcgi -f cgi -p 9001 -F 256

裁剪后也仅支持接收这三个参数

作者对于Spawn-fcgi的思考

  • fastcgi 协议规定,fcgi管理器中把网络描述符定为FCGI_LISTENSOCK_FILENO,为了一致CGI程序中复用FCGI_LISTENSOCK_FILENO的套接字,总感觉不是很完美。
  • Spawn-fcgi太简单,不需要单独做一个软件,完全可以集成到cgi程序中
  • Spawn-fcgi使用的是多进程,如果集成到cgi程序中,可以自由选择多进程模型、多线程模型
  • 缺少进程守护监控,spawn-fcgi如果一个进程挂掉,不会被重启。
  • Spawn-fcgi 网络多路复用调用的是select,但现在最常用的是epoll

Spawn-fcgi 补充知识

与原版相比,裁剪后Spawn-fcgi的失去了哪些功能

  • 使用linux套接字文件建立tcp连接功能
  • 对IPv6的支持
  • 对root、group 用户的检查
  • 对windows、Solaris等编译环境的支持
  • 通过进程pid文件获取cgi进程
  • 去除对autoconf等编译工具的依赖
  • …